

Михаил Шумовский: собрал ИИ-редакцию в Claude Code и сократил работу над статьей с 5–8 часов до часа
Михаил Шумовский, главный редактор Нейромедиа и маркетолог Нейроцеха. Работает с нейросетями с первых дней ChatGPT, и сейчас все статьи для блога клуба пишут они.
В кейсе рассказываем, как Михаил прошел путь от одного огромного промпта в чате до собственной ИИ-редакции. Теперь фактуру и черновик готовят агенты, а сам Михаил сидит над статьей примерно час.
Начал писать статьи с нейросетью и завел по промпту на каждый этап
До нейросетей на статью-подборку у меня уходило часов пять, а на сложную тему с экспертами — восемь и больше. В месяц я успевал написать 15–18 статей. При чем даже столько получалось написать, только выкладываясь на максимум.
Затем в мир пришли нейросети и я стал использовать ChatGPT как только он вышел в открытый доступ. Как и все я по-началу закидывал в нейронку промпт по типу «сделай хорошую статью» и надеялся на что-то годное с перового захода. Но очень быстро я понял, что работу нужно дробить на этапы, а под каждый писать свой идеальный промпт.
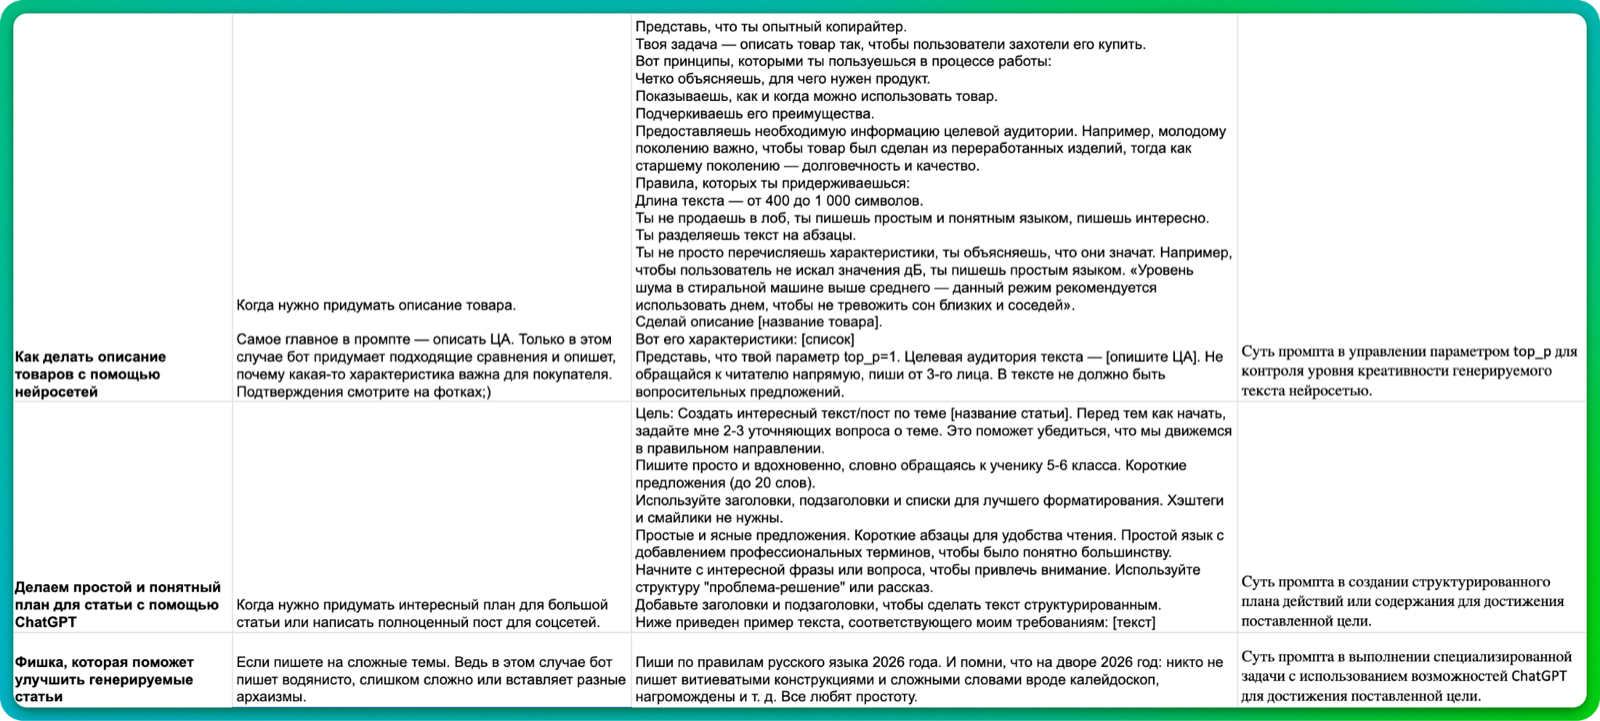
Поэтому я взял все этапы, через которые статья проходит в любой редакции, и сделал промпт под каждый этап. Сначала выбирал тему и собирал под нее фактуру. Потом строил по фактуре план, проверял и одобрял его. И только по готовому плану писал черновик, редактировал и в самом конце проверял факты.
Все нейросети в одном окне
Текст, картинки и видео в агрегаторе Нейроцеха. На старте 3000 кредитов в подарок
Начать бесплатноНа ранних моделях я делал каждый этап в отдельном чате: целая статья не помещалась в контекстное окно, то есть модель не могла удержать столько текста за раз. Со временем всю статью я стал писать в одном чате.
Промпты под этапы помогали, но работу все равно ускоряли не так сильно, как мне хотелось.
Понял, что все решает план, и стал собирать его вместе с нейросетью
Главным из всех этапов оказался план. Какой план я давал нейросети, такой текст она и писала. Если туда попадал недостоверный факт или неправильно сформулированная мысль, нейронка с радостью раскрывала их в статье. Текст выходил вылизанным и отшлифованным, но стоило начать его читать, и становилось понятно, что внутри полный бред.
Я много раз пытался научить нейросеть собирать план самой: рассказывал, как искать и собирать информацию и как выстроить повествование под конкретную аудиторию. Но полностью автоматизировать это так и не вышло. Нейронка часто находила очень крутую и полезную информацию, которая в конкретной статье была ни к чему.
Так что план я начал собирать на пару с нейросетью. Это было быстрее, чем перекладывать все на нее, а потом вносить кучу правок.
Причем короткого плана нейросети было мало. По списку из пяти пунктов с тремя подпунктами в каждом она писала много отсебятины: из такого списка ей было не понять, о чем и зачем каждый раздел. Поэтому по каждому разделу я расписывал три вещи:
- О чем здесь рассказываем.
- Какой путь читатель проходит от одного понимания к другому.
- Что в разделе обязательно нужно упомянуть.
Например, один раздел плана у меня мог выглядеть так:
Раздел первый. Объясняем, зачем дробить работу на этапы. Читатель приходит с привычкой решать все одним промптом и уходит с пониманием, почему так не выходит. Обязательно упомянуть, что к середине текста модель растеряет часть требований.
Только по такому плану нейросеть с первого раза выдавала вменяемый черновик, который оставалось отредактировать.
А факты в готовом плане я для уверенности проверял отдельным промптом:
Я хочу, чтобы ты полностью проверил факты в этом плане. Не оставляй без внимания ни одной детали. Сначала внимательно прочитай текст и выдели из него каждое отдельное утверждение — в итоге у тебя должен получиться список фактов. Затем для каждого факта проведи тщательное исследование и определи, истинный он, ложный или неясный. Постарайся найти как минимум три независимых, качественных и надежных источника на каждый факт. Когда закончишь, составь таблицу, где для каждого утверждения будут указаны результаты проверки и ссылки на источники.
Скажу честно: еще во времена GPT-4o, я перестал запускать этот промпт, потому что на моих задачах модели стали реже галлюцинировать.
Даже по хорошему плану текст звучал ИИшно, и я начал собирать антипаттерны
Чтобы текст по плану еще и звучал хорошо, я очень долго объяснял нейросети, как формулировать мысли, раскрывать их и подавать. Пересказывал ей много правил из книги «Пиши, сокращай», показывал еще больше примеров. Что-то срабатывало, а что-то нет.
Так у меня появился большой промпт для генерации текстов. Внутри были правила вроде таких:
- Абзацы короткие, 2–4 предложения. Один абзац — одна мысль. Если в абзаце две мысли, даже связанные, разбивайте на два абзаца. Внутри абзаца сохраняется плавность, есть связки и переходы. Исключение: объяснение новой концепции или описание процесса может занимать 4–6 предложений в одном абзаце. Дробить такой абзац на 3-4 кусочка по 1-2 предложения не нужно — текст станет рваным. Ориентир: абзац должен читаться как связный блок, а не как список тезисов.
- Предложения должны быть полными, с подлежащим и сказуемым. Не пропускаем важную информацию. Если для понимания нужен контекст, даем его.
- Каждое предложение должно двигать мысль вперед. Если предложение можно убрать и смысл абзаца не изменится, его нужно убрать. Это касается пояснений, которые очевидны из контекста, и деталей, которые не влияют на понимание.
- Каждый блок текста имеет одну задачу: объяснить, показать на примере, дать инструкцию к действию, предупредить.
Таких пунктов было много, и внутри одного чата нейросеть их хорошо улавливала. Но проблемы со стилем все равно оставались.
В какой-то момент я понял, что не так: тексты нейросети звучали вроде бы правильно, но так, как человек на русском никогда не скажет. Думаю, дело в том, на чем модели учатся, а учатся они в основном на англоязычных текстах. Поэтому нейросеть, когда пишет, как бы формулирует мысль на английском, а потом переводит ее на русский. Где-то перевод выходит неточным, где-то теряется контекст, а строй предложения в английском вообще другой. Модель путается — отсюда, по-моему, и неестественные конструкции.
Главный маркер такого текста для меня — глаголы в настоящем времени. Модель любит писать «нейросеть генерирует сайт» или «сервис создает презентацию», хотя по-русски в таком контексте скажут «нейросеть поможет сгенерировать сайт» и «можно создать презентацию». Статья просто рассказывает, на что способен сервис, а настоящее время звучит так, будто он прямо сейчас что-то делает у читателя на глазах. Из-за этого возникает диссонанс, и текст сразу читается как машинный.
Нейроцех в телеграме
Инструменты, промпты и разборы про ИИ — коротко и по делу
ПодписатьсяЕсть и другие частые маркеры: канцелярит вроде «данного инструмента», пассивные конструкции и пустые усиления. А еще нейросеть то вставит «стоит отметить», то сделает драматичный вывод на ровном месте, то выдаст подряд несколько рубленых однообразных фраз.
Маркеров набралось столько, что к промпту для генерации в итоге добавился второй — для редактуры. В него я выписал антипаттерны: все сигналы, которые добавляют тексту ИИшности. Там же я прямо написал, что это не запрещенные слова и важно, в каком контексте они стоят. Для проверки был один простой вопрос: а в русском языке так вообще говорят? Если нет, предложение нужно переформулировать. Такой прием на удивление работал хорошо.
Собрал все промпты в одну редполитику и месяц дообучал ее на своих правках
Работать хотелось быстрее, а копировать по несколько промптов туда-сюда мне к тому моменту просто надоело. Заодно прокачались и сами нейросети: модели научились держать в голове длинную инструкцию целиком. Так что я решил чуть упростить себе жизнь.
Все, что накопилось, кроме промпта для плана, я собрал в один большой документ. Сам я называл его обвязкой, а в редакциях такие штуки называются редполитикой. По сути, это сборник правил, который получает новый автор в редакции: для кого мы пишем, как формулировать мысли, что можно, а чего нельзя. Туда же я записал, как искать и проверять информацию, и перенес все антипаттерны. А еще добавил короткие примеры хороших опубликованных текстов: постов, подборок, гайдов, кейсов. По ним модель должна была ловить ритм и понимать, как звучит готовый материал.
Такой документ я, само собой, собрал не с первого раза. Поначалу результаты были не очень: нейронка не учитывала многие правила и теряла инструкции. Поэтому редполитику я стал дорабатывать прямо на ходу. Я писал статью вместе с нейросетью и вычитывал все, что она выдавала. Попадалось место, где она ошиблась или не так раскрыла мысль, — переписывал его сам. Потом показывал модели свой вариант и спрашивал:
Почему в прошлый раз ты не справилась и не написала так, как мне нравится, а у меня получилось? Что в моем тексте отличается от твоего?
Нейросеть разбирала разницу: где я иначе построил предложения, где по-другому раскрыл мысль и за счет чего вышло лучше. Эту разницу я просил оформить в правило и дописывал его в редполитику, чтобы на похожей задаче модель ту же ошибку уже не повторила.
В таком режиме я проработал примерно месяц. За это время редполитика доросла до полноценного файла страниц на десять. Позже редполитик стало несколько — своя под каждое направление моей работы.
Чтобы не писать по одной статье за раз, перешел в Claude Code и Cursor
Но даже с готовой редполитикой я писал статьи строго друг за другом. Взяться за несколько сразу было неудобно: приходилось прыгать между чатами, забирать оттуда готовые блоки и уносить их в гугл-док. Писал я тогда не весь текст сразу, а по одному-два блока, так что и переносить его приходилось по кусочку.
Тогда я решил дойти до максимальной автоматизации. Хотелось, чтобы весь текст блок за блоком писала нейросеть и сама сохраняла его в отдельный файл, а мне оставалось только отредачить его или сразу забрать в доки.
Под эту задачу я выбрал Claude Code от Anthropic. Он живет прямо внутри папки на компьютере и подхватывает все, что в нее положишь. Мне как раз и было нужно, чтобы редполитика и готовые тексты лежали в одном месте и ничего не приходилось таскать руками.
Только по умолчанию Claude Code работает в терминале — окне, где все команды вводят текстом. Как любой нормальный НЕайтишник, когда я впервые столкнулся с терминалом, понял, что мне такое счастье не надо.
Научитесь создавать тексты с помощью нейросетей: от выбора подходящего ИИ-инструмента и написания эффективных промптов до работы с референсами, фактчекинга и редактуры готовых статей и постов.
- Миникурс
- ChatGPT
- Claude
- Gemini
Поэтому я быстренько ушел на Cursor. Это оболочка с обычным графическим интерфейсом, а Claude Code подключается к ней расширением. Слева в Cursor видно все файлы проекта, а в центре идет переписка с нейросетью, как в любом чате. Выбрал я его потому, что он оказался Гугл Документами для работы с файлами: все на виду, и ни одной команды вводить не нужно.
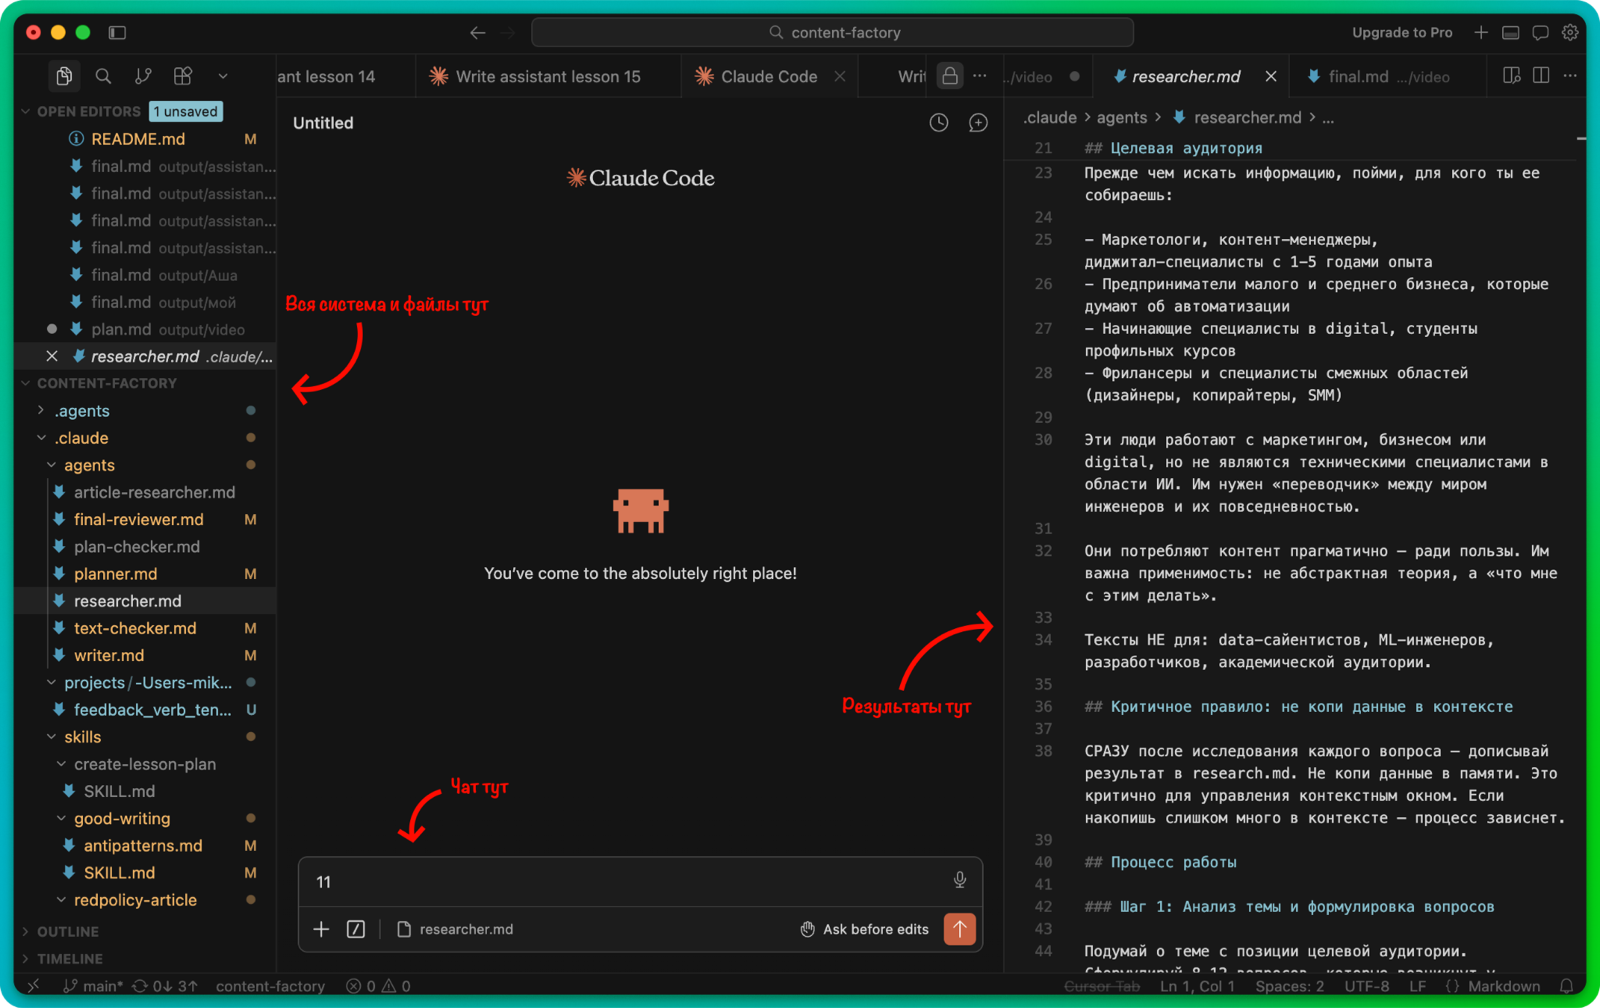
За Cursor я вообще не платил: как оболочку его можно использовать бесплатно. А на Claude оформил подписку за $100 в месяц.
Попросил Claude собрать из редполитики редакцию из агентов
Когда я настроил рабочее место, пришла очередь самой редакции. Я создал на рабочем столе папку и сложил туда все редполитики, какие у меня были. Потом открыл Claude Code и описал обычными словами, чего хочу. Запрос звучал примерно так:
Я хочу внутри этой папки выстроить систему для генерации контента — полноценную ИИ-редакцию: сначала я делаю план, потом этот план проверяется, потом по плану пишется статья, она проверяется, и финальную версию я смотрю сам. Давай продумаем, как это устроить и как декомпозировать работу на агентов, чтобы каждый отвечал за свой кусок. Расскажи, как это сделать и какая информация тебе нужна от меня.
Программировать ничего не пришлось. Claude сам предложил разбить работу на роли, как в настоящей редакции: планировщик, рецензент плана, автор, редактор, фактчекер, корректор и выпускающий. Потом он начал задавать уточняющие вопросы: откуда берется план и на каком этапе я хочу лично утверждать результат. Спросил и о том, нужен ли веб-ресерч с проверкой по источникам и сколько статей я собираюсь писать в потоке. Я ответил, и Claude продолжил собирать систему уже под мой процесс.
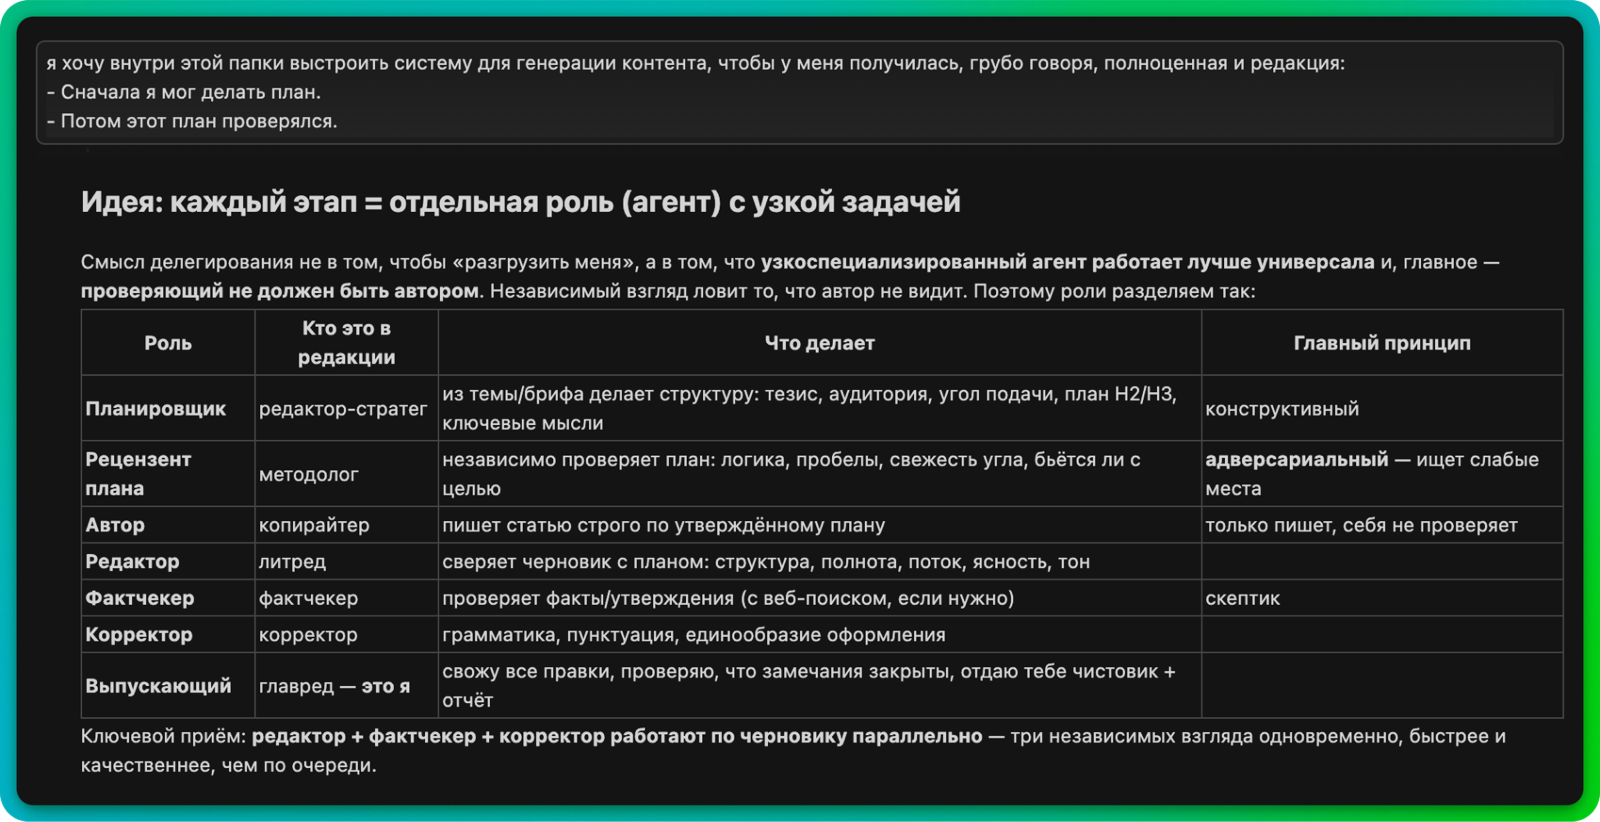
В готовой системе у каждого этапа, от сбора фактуры до вычитки, появился свой агент — исполнитель внутри Claude Code. Как сотрудник в редакции, агент занят только своим делом: план строит планировщик, а за факты отвечает фактчекер. Но агенту нужно подробно объяснить, что и как делать. Поэтому главное, что сделал Claude, — разобрал мою редполитику на скиллы. Скилл — это такая инструкция для одного агента: что он делает, откуда берет информацию и на что обращает внимание.
Роли я оставил не ради красоты. Когда у агента одна роль, ее можно расписать во всех подробностях. А раз он отвечает только за свой кусок, ему хватает внимания, чтобы что-то поискать и перепроверить, не отвлекаясь на остальное. А в одной инструкции на все этапы сразу все детали просто не учесть.
Теперь темы подбирает нейросеть по данным Bukvarix
Сейчас путь любой статьи по этой редакции, в том числе для блога Нейроцеха, начинается с темы. Выбирать ее наугад, как раньше, я перестал: придумать тему, которая окажется и интересной, и популярной (а это очень важно), сложно. Практически невозможно.
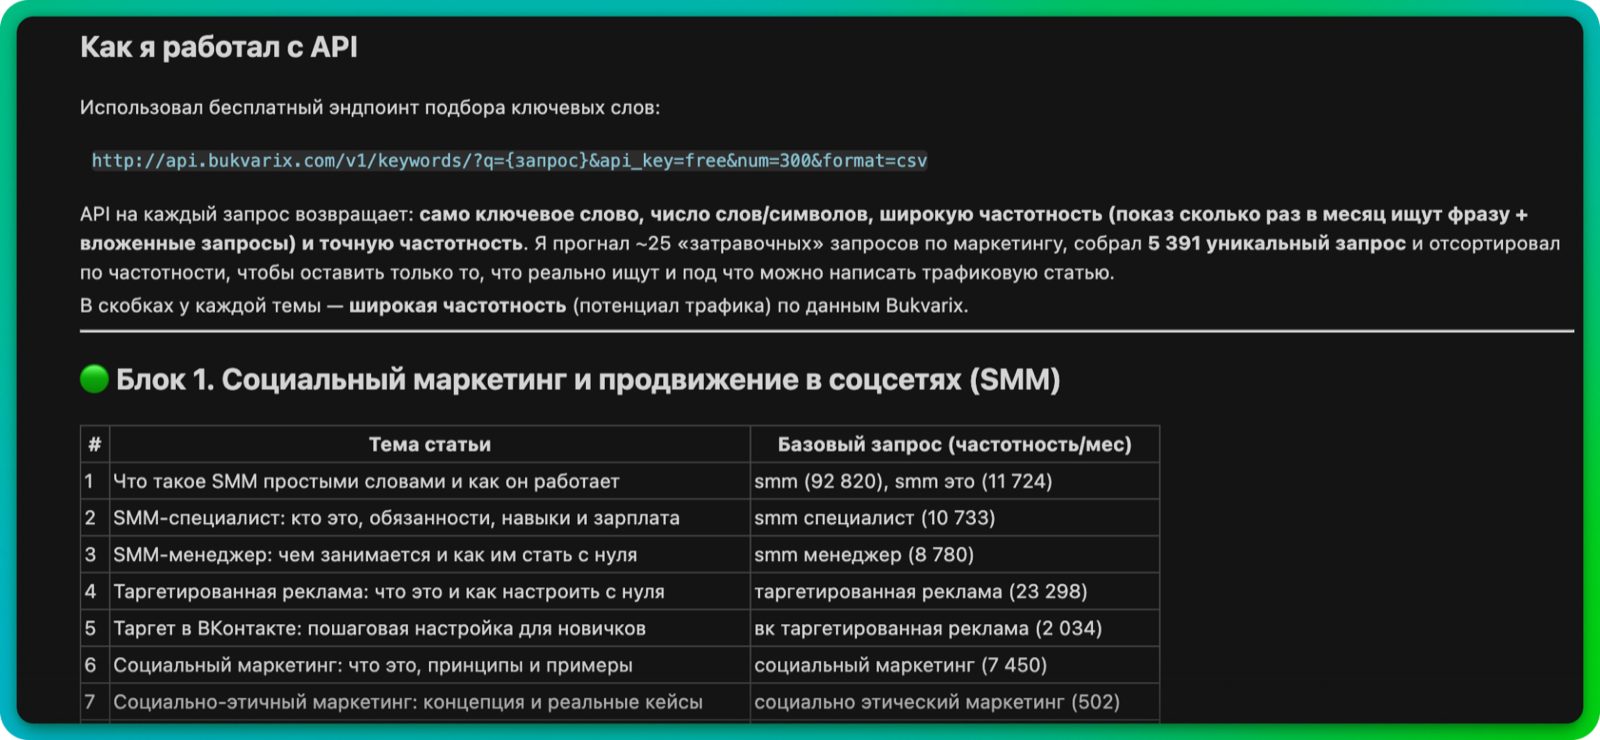
Вместо этого я отдаю нейронке API сервиса Bukvarix, и через него она сама ходит туда за данными. Bukvarix бесплатный и подключается к тому самому Wordstat: по любому запросу он собирает 250 первых ключевых фраз из выдачи. С Wordstat можно было бы работать и напрямую, но я живу в Беларуси, а с сервисами Яндекса здесь разные сложности.
Сферы для поиска задаю я, а нейронка минут тридцать шерстит по ним разные запросы. Потом она приносит мне 50 возможных тем и по каждой показывает частотность и потенциал. Обычно 5–7 из них звучат ничего — их я и забираю в работу.
Врать не буду: параллельно я и сам смотрю блоги конкурентов и думаю, о чем еще таком можно написать. Но скоро обленюсь делать и это — настрою парсер, который будет следить за всеми конкурентами вместо меня.
Фактуру собирает агент, а для новых сложных тем я включаю Deep Research
Отобранная тема первым делом попадает к агенту, который отвечает за фактуру. Что ему искать, зависит от типа статьи. Если это подборка с мини-обзорами, агент справляется сам: находит цифры, описания сервисов, тарифы и то, как сейчас выглядят их интерфейсы.
Я только напоминаю ему, какой год на дворе, и требую обязательно проверять информацию в интернете. Иначе он положится на свои устаревшие знания или пойдет в сеть с неправильным запросом и наткнется на неактуальную статью.
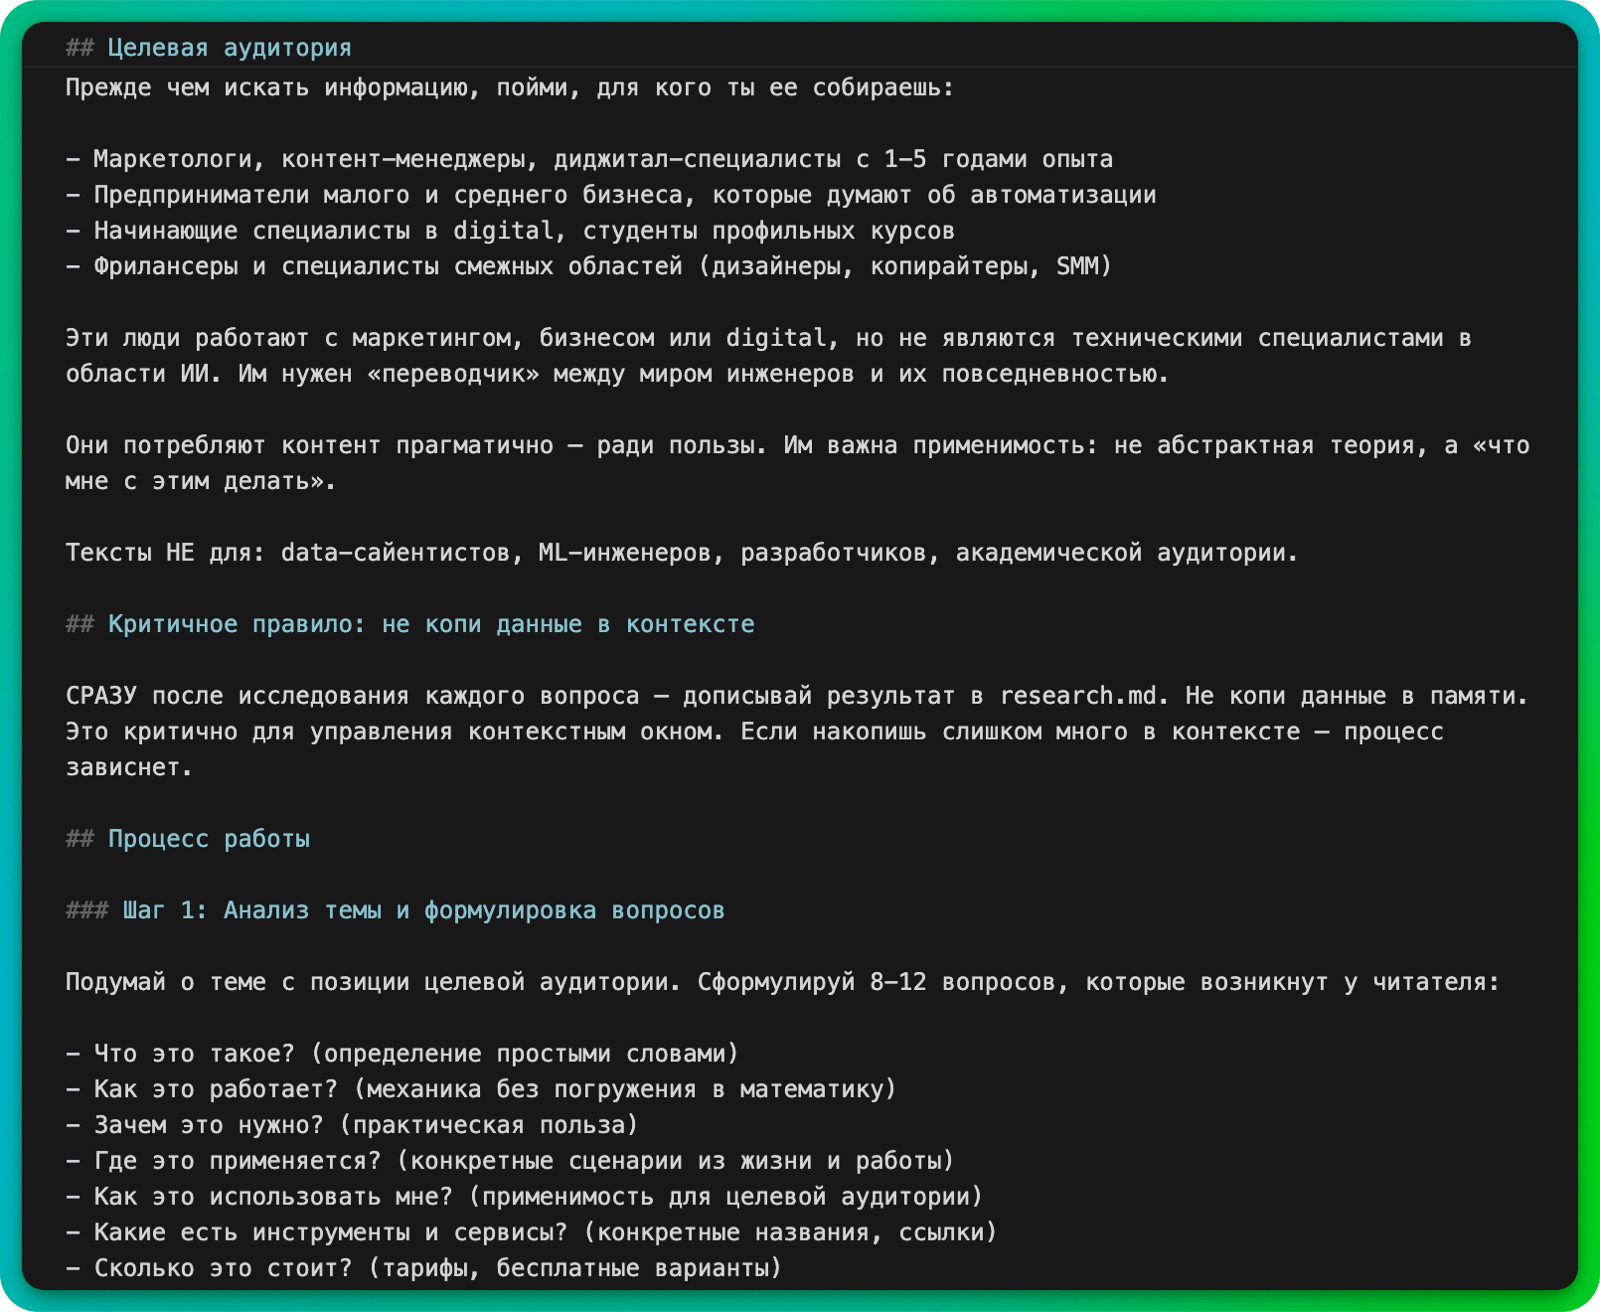
Для сбора фактуры с головой хватает обычного поиска. Свежие модели проверяют сразу несколько сайтов и сверяют найденное с чужими статьями. Если какой-то сайт не отдает часть контента, модель сама уходит на другой и добирает данные там. Поэтому дополнительные парсеры, которые выкачивают содержимое страниц, я агенту не подключаю: они только съедают контекстное окно и тратят лимиты.
Если же тема новая и сложная, а сам я в ней пока не разбираюсь, агенту я ее не отдаю: фактуру собираю сам и включаю режим Deep Research. В нем нейросеть изучает гораздо больше ссылок за раз и глубже разбирается в задаче.
Статью пишет цепочка агентов, а по ее файлам видно, кого из них дорабатывать
Когда фактура собрана, по ней мы вместе с агентом-планировщиком строим план, а другой агент этот план проверяет.
Потом хватает одной команды: за текст в фоновом режиме берется агент-писатель. Работает он в том же поблочном ритме, в каком я когда-то вел статьи в чатах: берет план, перечитывает все, что уже написано, и дописывает следующие два блока. Так он доходит до конца статьи без моего участия, а готовый черновик напоследок вычитывают редактор и фактчекер.
После каждого запуска остается вся история работы над статьей. Фактура, план, черновик, замечания редактора и финальная версия лежат отдельными файлами.
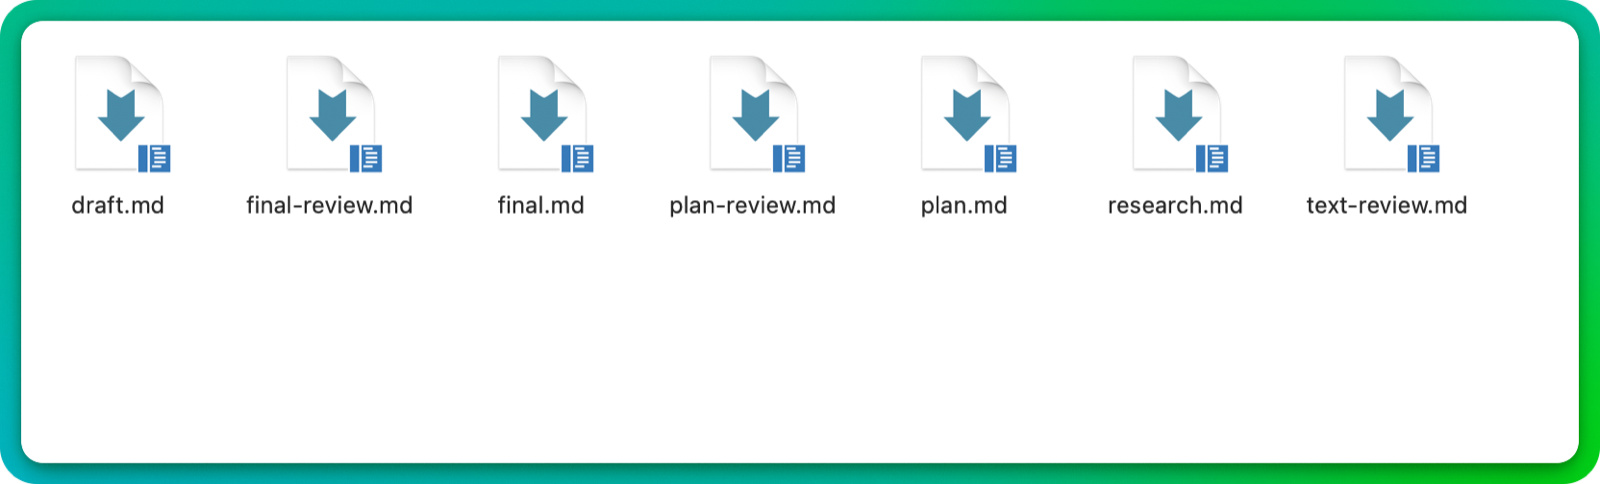
Как и все остальное в системе, это Markdown-файлы: обычный текст, который прочитает любая нейросеть. Поэтому в папке с редакцией у меня работает не только Claude, но и Codex от OpenAI, и Gemini.
По промежуточным итогам я сразу понимаю, какое звено в цепочке барахлит. Если слабым вышел план, я правлю планировщика. Текст кринжовый — значит, дело в писателе или в самой редполитике. А если в статье много дублей, усиливаю проверку. Дообучаю агентов я так же, как когда-то редполитику: если агент написал криво или упустил что-то важное, я спрашиваю, чего не хватило в его скилле, и он сам дописывает туда недостающее.
Тексты из Claude Code выходят суше, поэтому финальную правку делаю сам
Как бы я ни старался, добиться идеального текста только внутри Claude Code у меня не получилось. Нейросеть пишет там суховато, а порой текст получается чересчур рубленым и механическим.
Поэтому перед публикацией каждая статья проходит еще один этап. Материал я отдаю веб-версии Claude, то есть чату в браузере, и прикладываю к нему редполитику единым файлом. Нейросеть еще раз просматривает текст, находит, что можно поправить по мелочи, и сама это дорабатывает.
После этого текст попадает ко мне, ведь выпускающий в этой редакции — я. Дальше я довожу его руками, и как раз на эти мелкие правки уходит от 30 минут. Где-то поправляю те самые глаголы, где-то отдельные фразы, а иногда чуть перестраиваю целые предложения: так выходит быстрее, чем просить поправить нейросеть.
Со сложными темами ручной работы больше. Их я по большей части веду сам: управляю процессом и надиктовываю нейросети, что писать. Юридическую, медицинскую или финансовую тему приходится пристально проверять на всех этапах: нейросеть не чувствует, какую информацию и как подать, и легко пропускает важное. Сколько доверять нейросети, зависит еще и от того, знаю ли я тему. Если знаю, доверяю ей спокойнее: ошибку я замечу и ничего важного не упущу. Если нет, фактуру и проверку фактов беру на себя.
При тех же 15–18 статьях в месяц успеваю работать маркетологом и главредом
Сам я трачу на статью около часа, изредка до двух. Часы, когда нейросеть работает без меня, я в расчет не беру: пока она собирает фактуру или пишет черновик, я занимаюсь другими делами. Раньше, когда я писал все руками, 15–18 статей в месяц были для меня пределом. Сейчас статей выходит столько же, только теперь на мне еще обязанности маркетолога и главреда, и я все успеваю.
По подпискам выходит так. Claude у меня по-прежнему за $100 в месяц: в один пятичасовой лимит помещается до трех статей, и мне этого более чем достаточно. За Codex я начинал платить $20, этого хватало на одну-две статьи, а сейчас плачу тоже $100.
В блоге Нейроцеха все тексты пишутся нейронками. И мне не стыдно.
Нейросеть для меня просто инструмент, такой же, как Google-таблицы или Word. Помню, как я писал статьи в Word, мучился с форматированием и прыгающими картинками, а потом перешел на Google Docs и сразу понял, насколько так удобнее. С нейросетями то же самое: если ради хорошего результата приходится каждый раз изворачиваться и страдать, я ухожу туда, где работать быстрее и проще. Многие так привыкли к GPT-4o, что писали жалобы Сэму Альтману, главе OpenAI, и не хотели переходить на другие модели. А рядом уже был Claude, который писал в разы сильнее.
Бесплатные модели вроде DeepSeek, Qwen или Kimi хороши на простых задачах, и пользоваться ими точно можно. Но если статью на DeepSeek я напишу за три часа, то с Claude на нее уйдет час-полтора. Поэтому для постоянной работы в потоке я беру Claude, ChatGPT или Gemini. А сэкономленного времени хватит еще на одну статью, которая отобьет мне стоимость подписки и позволит заработать сверху.
Больше всего в работе с нейросетью меня утомляло каждый раз начинать с пустого чата. Снова и снова приходилось объяснять ей стиль, аудиторию, ограничения, факты и структуру. Куда приятнее оказалось один раз настроить процесс и собрать под него редполитику с правилами и примерами. Теперь я пишу заметно быстрее, причем неважно, по одной статье в веб-версии или на потоке в Claude Code.
В Нейроцехе общаюсь с участниками и подсматриваю у них лайфхаки
Когда Нейроцех только запускался, в него вступали по большей части авторы и маркетологи. Я делал все гайды и выступал в роли передатчика инфорации: пробовал кучу всего сам, а потом писал про это гайд и помогал попробовать другим. Но со временем ядро клуба сменилось, к нам стали приходить владельцы бизнесов, аналитики, разработчики и другие классные ребята, у которых я сам многому научился. В том числе вайб-кодингу и ИИ-ассистентам.
Поэтому я искренне считаю Нейроцех невероятным местом — я пришел сюда работать, учить других и зарабатывать, а в итоге еще и стал учиться сам и прокачался в огромном количестве направлений. Даешь Нейроцех в каждый дом!