Денис Максимов: разобрал архив рекламного агентства с помощью ИИ и нашел неоплаченные работы примерно на 300 000 рублей
В кейсе рассказываем, как Денис Максимов восстанавливал историю клиентских заказов по договорам, подтверждениям переводов и сообщениям менеджеров. Первые попытки в ChatGPT и Claude давали неверные расчеты, и он перешел к поэтапной обработке с ИИ-агентами и проверкой спорных случаев сотрудниками. Команда собрала базу старых сделок и обнаружила выполненные заказы, по которым не было оплаты.
Историю одного заказа приходилось собирать по разным чатам и папкам
В рекламном агентстве «Спираль» мы помогаем компаниям и экспертам продвигаться в мессенджерах, в том числе размещаем рекламные посты. По каждому заказу нужно было понимать, о чем договорились с клиентом, какую работу выполнили и получили ли за нее деньги. Ответы были в договорах, счетах, актах, платежках и переписках, но все это хранилось в разных чатах и папках менеджеров.
Сначала мы работали с клиентами в личных переписках. Потом появился один рабочий чат, затем другой, а кому-то снова стало удобнее обсуждать заказ в личке. Так сведения по сделкам оставались в разных местах. За четыре года у нас накопилось 22 200 файлов.
Когда требовалось вернуться к старой сделке, приходилось заново собирать ее историю: найти документы, перечитать сообщения, выяснить, к какому заказу относится перевод. Иногда из-за этого не успевали ответить клиенту вовремя и теряли сделку.
Мы решили собрать общую базу: по каждому клиенту — заказы, документы и сведения об оплате. Для этого предстояло восстановить старые сделки по накопившимся файлам: связать каждый договор с его счетами, актами и платежами, чтобы вся история работы с клиентом оказалась в одном месте.
Попробовал поручить разбор нейросетям, но при проверке суммы не сходились

Гайды, курсы, вебинары — и еще куча всего, чтобы нейросети работали на вас
Сначала мы пытались собрать эту базу вручную: переписать платежки в таблицу, найти к ним договоры и счета. Но у сотрудников оставалась основная работа, а на просмотр длинных переписок и сопоставление документов понадобились бы месяцы. Тогда я попробовал поручить разбор нейросетям.
Я уже пользовался ChatGPT и Claude, но только как обычными чатами: отправлял материалы и писал, что с ними нужно сделать. Так же подошел и к этой задаче. Мне казалось, что достаточно подробно все объяснить — и нейросеть сама разберется с накопленными данными.
В этих попытках я давал ей большие таблицы и просил посчитать суммы. Она утверждала, что все прочитала, выдавала расчеты, и на первый взгляд они выглядели убедительно. Но стоило проверить цифры, как оказывалось, что ответ не совпадает с нашими данными. Где-то нейросеть считала правильно, а в другом месте брала лишь похожие на настоящие значения.
В какой-то момент я просто забил: нафиг с ним работать, если он так тупит и не понимает. Тогда мне казалось, что все эти нейронки — обман и на самом деле ничего из этого не работает.
Разделил обработку архива между ИИ-агентами, чтобы каждый работал с небольшим объемом
Но у других людей работа с нейросетями получалась. Я смотрел на это и думал: раз у всех выходит, а у меня нет, значит, я что-то делаю не так. Чтобы научиться, я прошел базовый интенсив по вайбкодингу. Понял, как можно организовать такую работу, и вернулся к архиву.
Раньше я хотел одним промптом решить все наши проблемы и не учитывал, сколько информации нейросеть способна удержать при ответе. Этот объем называют контекстным окном. По моим наблюдениям, пока она читала огромные таблицы, часть нужных сведений терялась. Значит, стоило давать ей столько материала, сколько она сможет обработать без этих потерь.
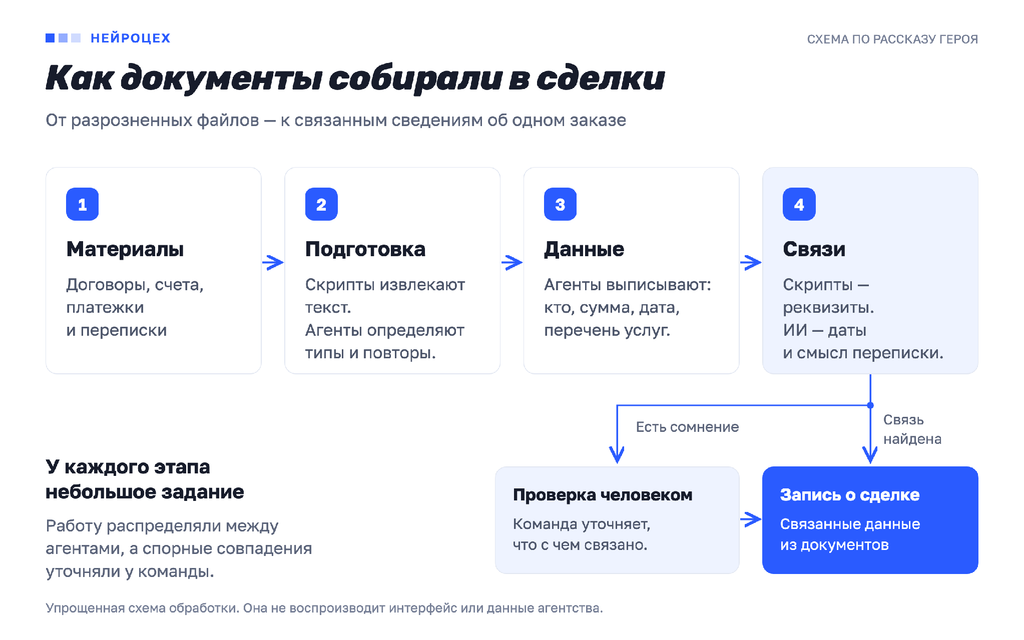
Я стал делить разбор на небольшие задания. Сначала подготовить файлы для чтения, затем выписать из них суммы, даты и сведения об участниках, после — найти документы, относящиеся к одному заказу. Повторяющиеся действия при подготовке файлов выполняли небольшие программы — скрипты. Для чтения документов и сопоставления по смыслу использовали нейросеть.
Эту работу выполняли ИИ-агенты — помощники, которым можно дать материал и поручить самостоятельно выполнить определенную задачу. Один получал порцию документов и извлекал сведения, другой работал с результатами и искал связи. У каждого была своя инструкция. Общую задачу я ставил главному агенту, а он сам раздавал небольшие поручения остальным. Так одному помощнику не приходилось разбираться со всем архивом сразу.
Все материалы мы выгрузили в папку проекта. С ними начали работать через VS Code — редактор, в котором можно открыть файлы проекта и работать с кодом. В рамках этого проекта я и обсуждал с нейросетью, как организовать разбор. Например, размер порции сам не рассчитывал: рассказал о прежних ошибках и попросил подбирать такой объем, чтобы она не теряла нужные сведения. По ходу работы мы уменьшали задания до подходящего размера.
Сначала агенты извлекали из договоров и платежек суммы, даты и реквизиты
В общей папке лежали текстовые документы, фотографии и скриншоты банковских выписок. Текст с изображений скрипты сохраняли в отдельные файлы, чтобы нейросеть могла читать его при анализе. При этом далеко не каждая картинка в архиве была документом. Поэтому отдельный агент определял, что перед ним, и отсеивал изображения, не относящиеся к учету.
Другой агент определял тип документа и искал повторные файлы. Договор могли несколько раз переслать на согласование с правками: в архиве лежало несколько версий, но относились они к одной сделке.
Из отобранных документов агенты выписывали данные участников сделки, суммы, даты и перечень услуг. Одному агенту за проход давали тридцать документов; несколько таких помощников работали одновременно, каждый со своей порцией. На выходе получались строки таблицы со сведениями из прочитанных файлов.
Затем ИИ связывал документы в сделки, а спорные совпадения мы проверяли сами
Теперь нужно было понять, какие из этих сведений относятся к одному заказу. Для начала поручили скрипту искать совпадения в номерах счетов, суммах и других реквизитах. По ним он объединял очевидно связанные документы. Но одного совпадения по сумме или названию компании для восстановления всей сделки было недостаточно.
Все нейросети
в одном флаконе
ChatGPT, Claude, Gemini
и другие — в агрегаторе Нейроцеха

Поэтому сложные случаи я отдавал отдельному агенту, который сопоставлял документы с перепиской. Он смотрел, что обсуждали с клиентом, сравнивал даты документов, время создания чеков и проведения платежей. Эти сведения помогали собрать вместе счет, договор, приложения, платежку и акт, относящиеся к одному заказу.
Когда агенту не хватало сведений для связи, он присылал нам вопросы. Мы сами разбирались с этими случаями и указывали, какой документ к чему относится. При этом отсутствие платежки в архиве само по себе еще не означало, что клиент не заплатил.
Около трех недель собирал и дорабатывал систему на документах агентства
На разработку всей системы ушло около трех недель. За первые три дня мы собрали схему обработки, а затем дорабатывали отдельные этапы на документах агентства: смотрели, где возникают ошибки, и уточняли задания агентам.
Проверку их работы тоже поручили нейросети. Для этого добавили агента-контролера: сначала он перепроверял все результаты и помогал улучшать инструкции, позже перешел к выборочной проверке. При этом спорные связи между документами мы продолжали разбирать сами.
Однажды контролер запустил слишком много агентов на тяжелой модели, и лимит подписки начал расходоваться слишком быстро. Мы обсудили с ИИ, как этого избежать. После этого он стал запускать меньше агентов одновременно, часть заданий выполнять по очереди и использовать модель поменьше. Нам нужно было сохранить качество разбора и уложиться в лимит подписки на пятичасовое окно.
На проект ушло около 30 000 рублей. В эту сумму вошли подписки на Claude Code, с которым работали над кодом системы, и использование моделей Claude.
Получили базу из 7 824 сделок и нашли неоплаченные работы примерно на 300 000 рублей
Когда убрали дубли и объединили документы, из архива получилось 7 824 уникальные сделки. Вместе с документами мы разобрали и накопившиеся переписки. Теперь для работы со сведениями по сделкам у нас одна таблица и один рабочий чат: больше не нужно перекидывать информацию между разными переписками, чтобы восстановить историю заказа.
Время поиска мы специально не замеряли. По нашим ощущениям, находить нужное стало намного быстрее — потому что теперь все собрано в одном месте.

Отдельно разбирались с оплатами. По двум менеджерам сохранились данные о поступлениях — по ним удалось найти соответствующие платежки для 728 сделок. Эту цифру мы получили при работе с их документами; она не описывает проверку всего архива.
Разбор также помог обнаружить почти тридцать неучтенных сделок, по которым работу выполнили, а оплату не получили. Сумма этих работ составила около 300 000 рублей.
На основе разобранного архива я начал делать CRM для финансов, документов и задач
Результаты обработки сначала были видны в текстовом виде в VS Code. Чтобы их было удобнее смотреть, мы начали делать дашборд — страницу с собранными данными. Это пока простая HTML-страница: открываешь файл в браузере и видишь состояние базы на момент его создания.
Теперь на основе этой работы я разрабатываю собственную CRM — систему учета клиентов и заказов. В ней хочу объединить финансы, документы, сделки и задачи команды. Готовую часть с разбором архива планирую встроить в нее и доработать под общий учет.
В Нейроцехе узнал про небольшие задачи, а порядок работы закрепил в скилле
Из обсуждений в Нейроцехе я взял подход к разделению большой работы на маленькие задачи. А порядок действий для разбора наших документов мы постепенно выстроили вместе с ИИ: обсуждали, что ему нужно сделать и как поступать в разных случаях.
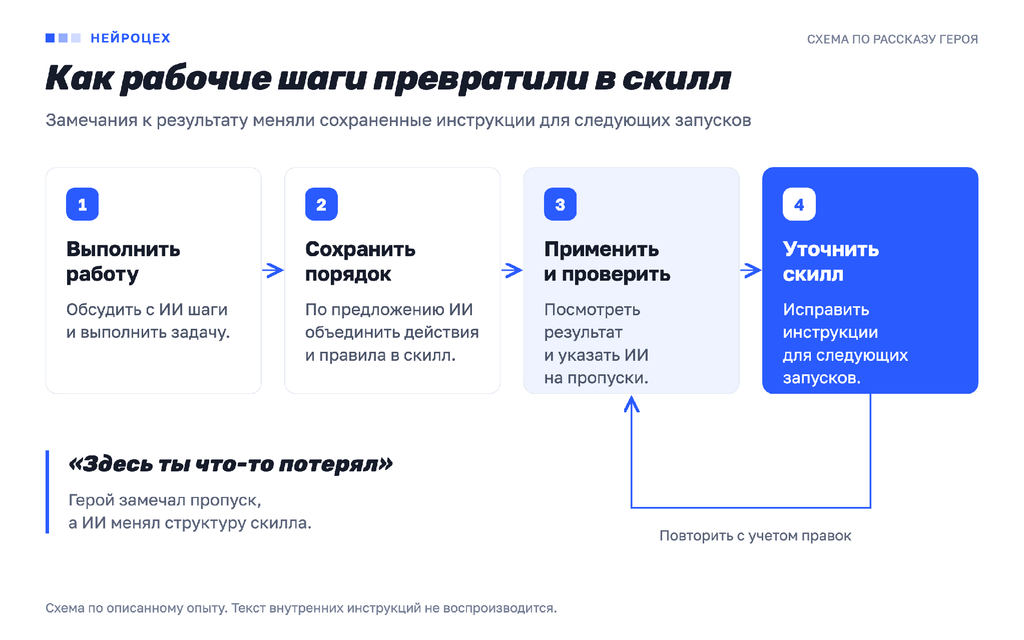
Когда этот порядок заработал, нейросеть предложила объединить шаги в скилл. Так появилась сохраненная инструкция: какие действия выполнять, в какой последовательности и по каким правилам. На следующем задании агент мог пройти по ней, и мне не приходилось заново объяснять весь процесс.
Дальше я смотрел на результаты и отмечал, что понравилось, что не подошло и где нейросеть потеряла сведения. По этим замечаниям она меняла сам скилл и следующую порцию документов обрабатывала уже по исправленной инструкции. Постепенно при разборе стало теряться меньше нужных сведений.